AI Inference Engine Optimization Makin Penting saat AI Beralih dari Cloud ke Perangkat Lokal

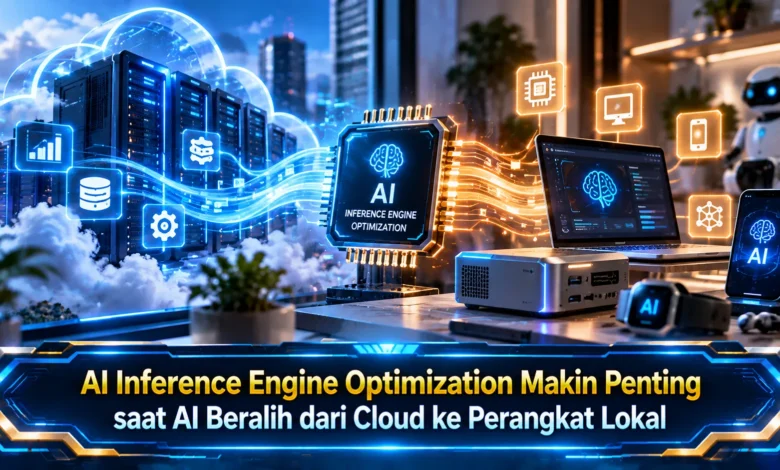
Perkembangan kecerdasan buatan mulai mendorong semakin banyak proses AI berjalan langsung pada smartphone, laptop, komputer, kendaraan, hingga perangkat edge tanpa selalu bergantung pada cloud. Perubahan ini membuat efisiensi inference menjadi semakin penting karena perangkat lokal memiliki batas daya, memori, temperatur, dan kemampuan komputasi. AI Inference Engine Optimization menjadi bagian penting dari perkembangan teknologi tersebut karena membantu model memanfaatkan CPU, GPU, NPU, memori, serta software secara lebih efisien agar pemrosesan AI lokal dapat berlangsung cepat dan responsif.
On Device AI Mengubah Cara Model Kecerdasan Buatan Dijalankan
Pada banyak implementasi kecerdasan buatan, proses komputasi sebelumnya banyak bergantung pada infrastruktur cloud dengan kapasitas komputasi besar. Pengguna mengirimkan input menuju server, model menjalankan proses inference, kemudian hasil dikirim kembali menuju perangkat. Pendekatan tersebut masih sangat berguna untuk model besar, tetapi perkembangan hardware membuat semakin banyak kemampuan AI dapat diproses langsung pada perangkat lokal.
Pemrosesan AI langsung pada perangkat menawarkan berbagai keuntungan yang dapat mencakup latensi yang lebih rendah, kebutuhan koneksi cloud yang lebih sedikit, serta peluang menggunakan fitur tertentu secara offline. Pemrosesan lokal juga dapat mengurangi kebutuhan mengirim sebagian data menuju server apabila arsitektur aplikasi memang dirancang untuk menjalankan proses tersebut di perangkat. Meski menarik, pendekatan tersebut menuntut teknologi AI bekerja secara efisien pada perangkat yang memiliki sumber daya lebih kecil dibandingkan infrastruktur cloud.
Optimalisasi Inference Membantu Model Berjalan Lebih Efisien
Optimalisasi inference engine pada dasarnya berusaha cara membuat proses eksekusi model berlangsung lebih cepat sekaligus menggunakan sumber daya secara efisien. Ketika inference berlangsung, model menggunakan hasil pembelajaran sebelumnya untuk menghasilkan prediksi, jawaban, klasifikasi, atau bentuk keluaran lainnya. Model dengan kompleksitas tinggi dapat membutuhkan kapasitas komputasi serta memori yang semakin besar.
Proses optimalisasi sangat dibutuhkan pada perangkat lokal sebab peningkatan performa tidak dapat dilakukan tanpa memperhatikan penggunaan energi. Smartphone harus mempertahankan daya tahan baterai, laptop perlu menjaga keseimbangan antara performa dan temperatur, sedangkan perangkat edge mungkin memiliki kapasitas memori maupun daya yang lebih terbatas. Oleh sebab itu, teknologi inference harus mengelola eksekusi model agar kemampuan perangkat dapat digunakan tanpa membebani sistem secara berlebihan.
CPU GPU dan NPU Berbagi Peran dalam Pemrosesan AI Lokal
Perangkat lokal masa kini dapat dilengkapi beberapa unit komputasi yang mempunyai karakteristik berbeda untuk menjalankan AI. CPU memberikan kemampuan komputasi serbaguna, GPU menyediakan paralelisme besar, sedangkan NPU menghadirkan akselerasi yang diarahkan pada beban kerja AI. Keberadaan beberapa unit pemrosesan memungkinkan sistem membagi pekerjaan berdasarkan karakteristik setiap operasi.
Inference engine dapat membantu mengatur eksekusi model agar kemampuan CPU, GPU, maupun NPU dimanfaatkan secara efisien. Sebagian operasi dapat memperoleh efisiensi lebih baik melalui NPU, sementara pekerjaan lainnya mungkin lebih cocok menggunakan GPU maupun CPU. Pembagian workload yang efisien membantu teknologi AI memperoleh manfaat dari hardware accelerator tanpa menambah proses yang sebenarnya dapat dihindari.
Quantization dan Optimalisasi Model Mendukung On Device AI
Salah satu strategi untuk membuat inference lebih ringan adalah menggunakan quantization. Teknik tersebut memungkinkan sebagian representasi numerik model menggunakan presisi lebih rendah sehingga kebutuhan memori serta komputasi dapat dikurangi. Pada hardware lokal, penghematan sumber daya memberikan manfaat besar sebab RAM, bandwidth memori, dan kapasitas komputasi jauh lebih terbatas dibandingkan server cloud.
Optimalisasi model tetap membutuhkan pengujian karena pengurangan presisi yang terlalu agresif dapat memengaruhi kualitas keluaran. Tim pengembang harus menyeimbangkan kapasitas model, waktu pemrosesan, kebutuhan RAM, efisiensi daya, serta mutu keluaran. Setiap hardware dapat memberikan karakteristik berbeda sehingga evaluasi pada perangkat target diperlukan untuk memperoleh teknologi inference yang efisien.
Manajemen Memori dan Energi Menentukan Pengalaman AI Lokal
Performa AI lokal tidak semata mata ditentukan oleh kecepatan unit komputasi. Sistem perlu memindahkan data serta parameter model menuju unit komputasi sehingga kecepatan memori dapat memberikan pengaruh terhadap waktu inference. Apabila aliran data berjalan kurang efisien, unit pemrosesan yang kuat dapat mengalami waktu tunggu sebelum memperoleh informasi yang diperlukan.
Penggunaan energi perlu mendapatkan perhatian ketika inference dipindahkan menuju perangkat pengguna. Inference yang terus menggunakan unit komputasi secara intensif dapat meningkatkan konsumsi baterai serta temperatur perangkat. Dengan demikian, inference engine perlu mengelola pembagian tugas, pemakaian memori, pemilihan unit komputasi, dan eksekusi workload agar performa tetap seimbang dengan efisiensi. Efisiensi semacam ini menjadi kebutuhan penting ketika teknologi AI lokal digunakan dalam berbagai aktivitas sepanjang hari.
Kesimpulan
AI Inference Engine Optimization menjadi semakin penting seiring lebih banyak fungsi kecerdasan buatan berpindah dari cloud menuju smartphone, laptop, dan perangkat edge. Pendekatan tersebut dapat memberikan latensi lebih rendah, mengurangi kebutuhan komunikasi dengan server, serta memungkinkan beberapa kemampuan berjalan langsung di perangkat. Akan tetapi, batas baterai, RAM, bandwidth memori, panas, serta kapasitas pemrosesan membuat optimalisasi menjadi kebutuhan penting. Hardware seperti CPU, GPU, dan NPU perlu didukung quantization, manajemen memori, serta software inference agar teknologi AI memperoleh performa optimal. Dengan kemajuan optimalisasi perangkat keras dan perangkat lunak, teknologi AI lokal dapat berkembang menjadi lebih cepat, efisien, serta mampu menangani workload yang semakin kompleks. Anda dapat mengikuti perkembangan teknologi AI Inference Engine Optimization sekaligus berdiskusi mengenai fitur on device AI yang paling berguna untuk perangkat masa depan.